TODO: Enhancing LLM Alignment with Ternary Preferences
阅读顺序 023 · 数据与偏好结构 · 已查阅全文
来源与核验
DPO-RK与扩散迁移在原清单中混入本条;本笔记只把可对照TODO原文的TOBT机制归为论文结论。
原清单位置:研究想法 #28 · 整理于 2026-10-30
一句话直觉
平局告诉模型
先理解问题
真实偏好数据包含质量相近
方法如何工作
TODO先以TOBT扩展偏好模型
放回偏好对齐的地图
与三候选可识别性论文不同
阅读边界
原清单把TODO与DPO-RK相关讨论
目标结构摘记( )
$I_{\rm tie}$表示是否平局
自测与动手
- 若参考模型对两个平局回答概率不同
, , ? - 人为平局与标注者群体意见分裂
, ?
**小实验
来源与阅读范围
论文原文
**核验补充
原清单摘录与附图( )
以下内容来自原研究清单
研究想法 #28
这项研究针对大型语言模型
Diffusion-DPO采用了一种基于间隔的过滤策略
Diffusion-DPO 采用一种基于边界
Diffusion-DPO 把 preference learning 变成了 truncated binary classification problem
Diffusion-DPO 通过过滤掉低间隔样本来隐式地假设偏好可分离性
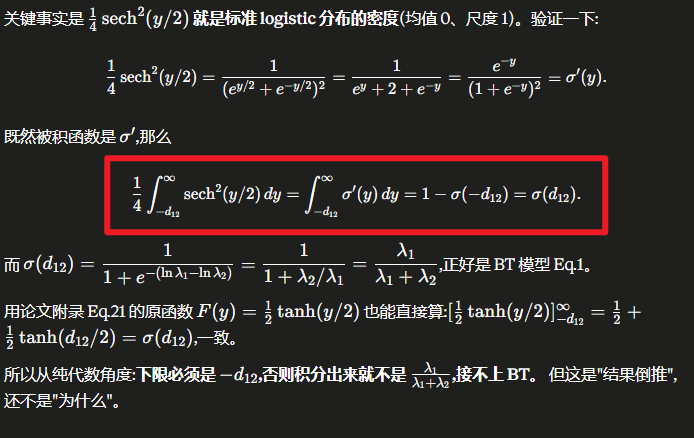
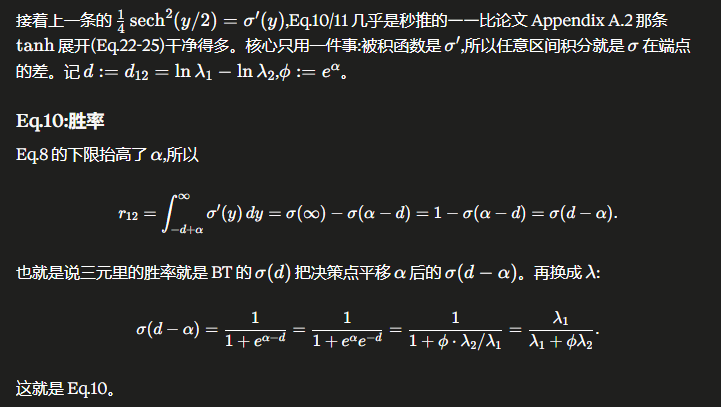
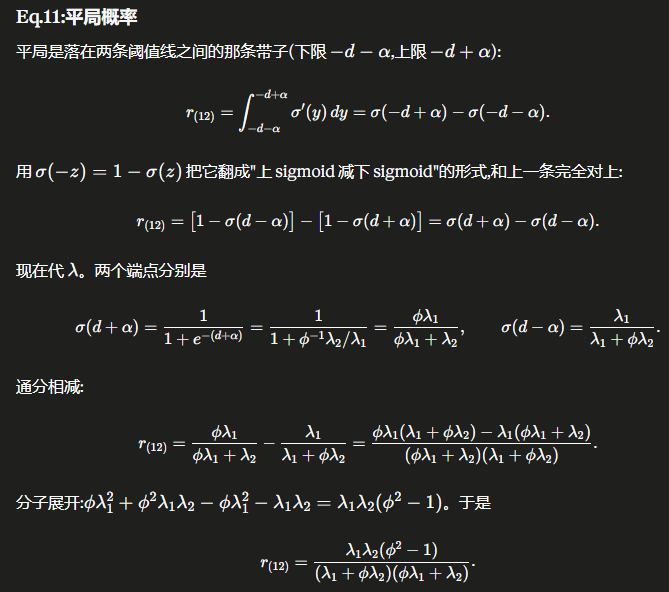
任何不允许平局可能性的模型
迁移到Diffusion-DPO
利用Pick-a-pic的平局数据做实验
-
在DPO-RK
( ) , : , ; “ ” , ( ) 。 , “ ” “ ” , 。 -
如果在原始的DPO模型中强行加入平局数据
, 。 , , , ( ) 。 , ( ) , -
传统DPO会直接丢弃这些评价冲突的样本
, “ ”
如何证明效果增益是来自
为了排除
- **核心控制组
: 。 :
-
DPO(CP)
: ( ) 。 -
DPO(CP+TP)
: , 。 -
DPO-RK(CP+TP)
: , 。
这里 DPO(CP+TP) 与新变体使用的数据集大小
-
原始DPO加入平局数据后
, , ( DPO(CP+TP)) , , 。 , , , -
只有引入平局项
, , , “ ” DPO-RK(CP+TP)时, 。 , ( ) ( ) , 。 ( ) 。 -
进一步验证
: ( ) , “ ” , : ( ) , “ ” ( ) , DPO(CP+rTP)。 , DPO(CP+rTP)的表现与DPO(CP+TP)同样糟糕, DPO-RK的表现依然大幅领先。 : ( ) , , 。
为什么平局项可以提升性能
加入平局项之所以能带来性能的提升
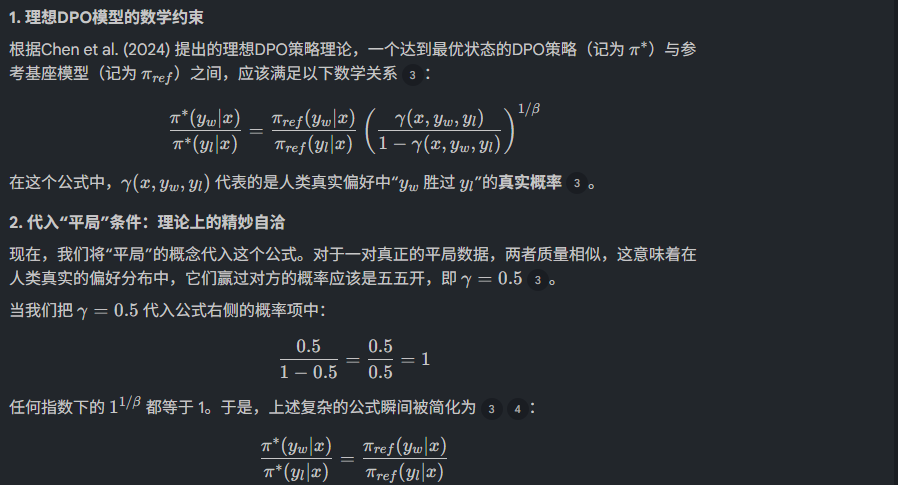
在传统的DPO中
加入平局项后