摘要
大型语言模型基于概率采样生成文本,但这并不意味着其输出的数字服从均匀分布。本研究以本地部署的 4-bit 量化模型 Gemma 4 E4B 为对象,分别测试了两种生成方式:一是逐次独立请求模型给出一个随机整数(共 240 次),二是要求模型一次性生成多个随机整数(共 40 批),合计收集 1,841 个有效数值。实验覆盖三种数值区间(0–9、1–10、1–100)和两种提示语言(英语、中文)。
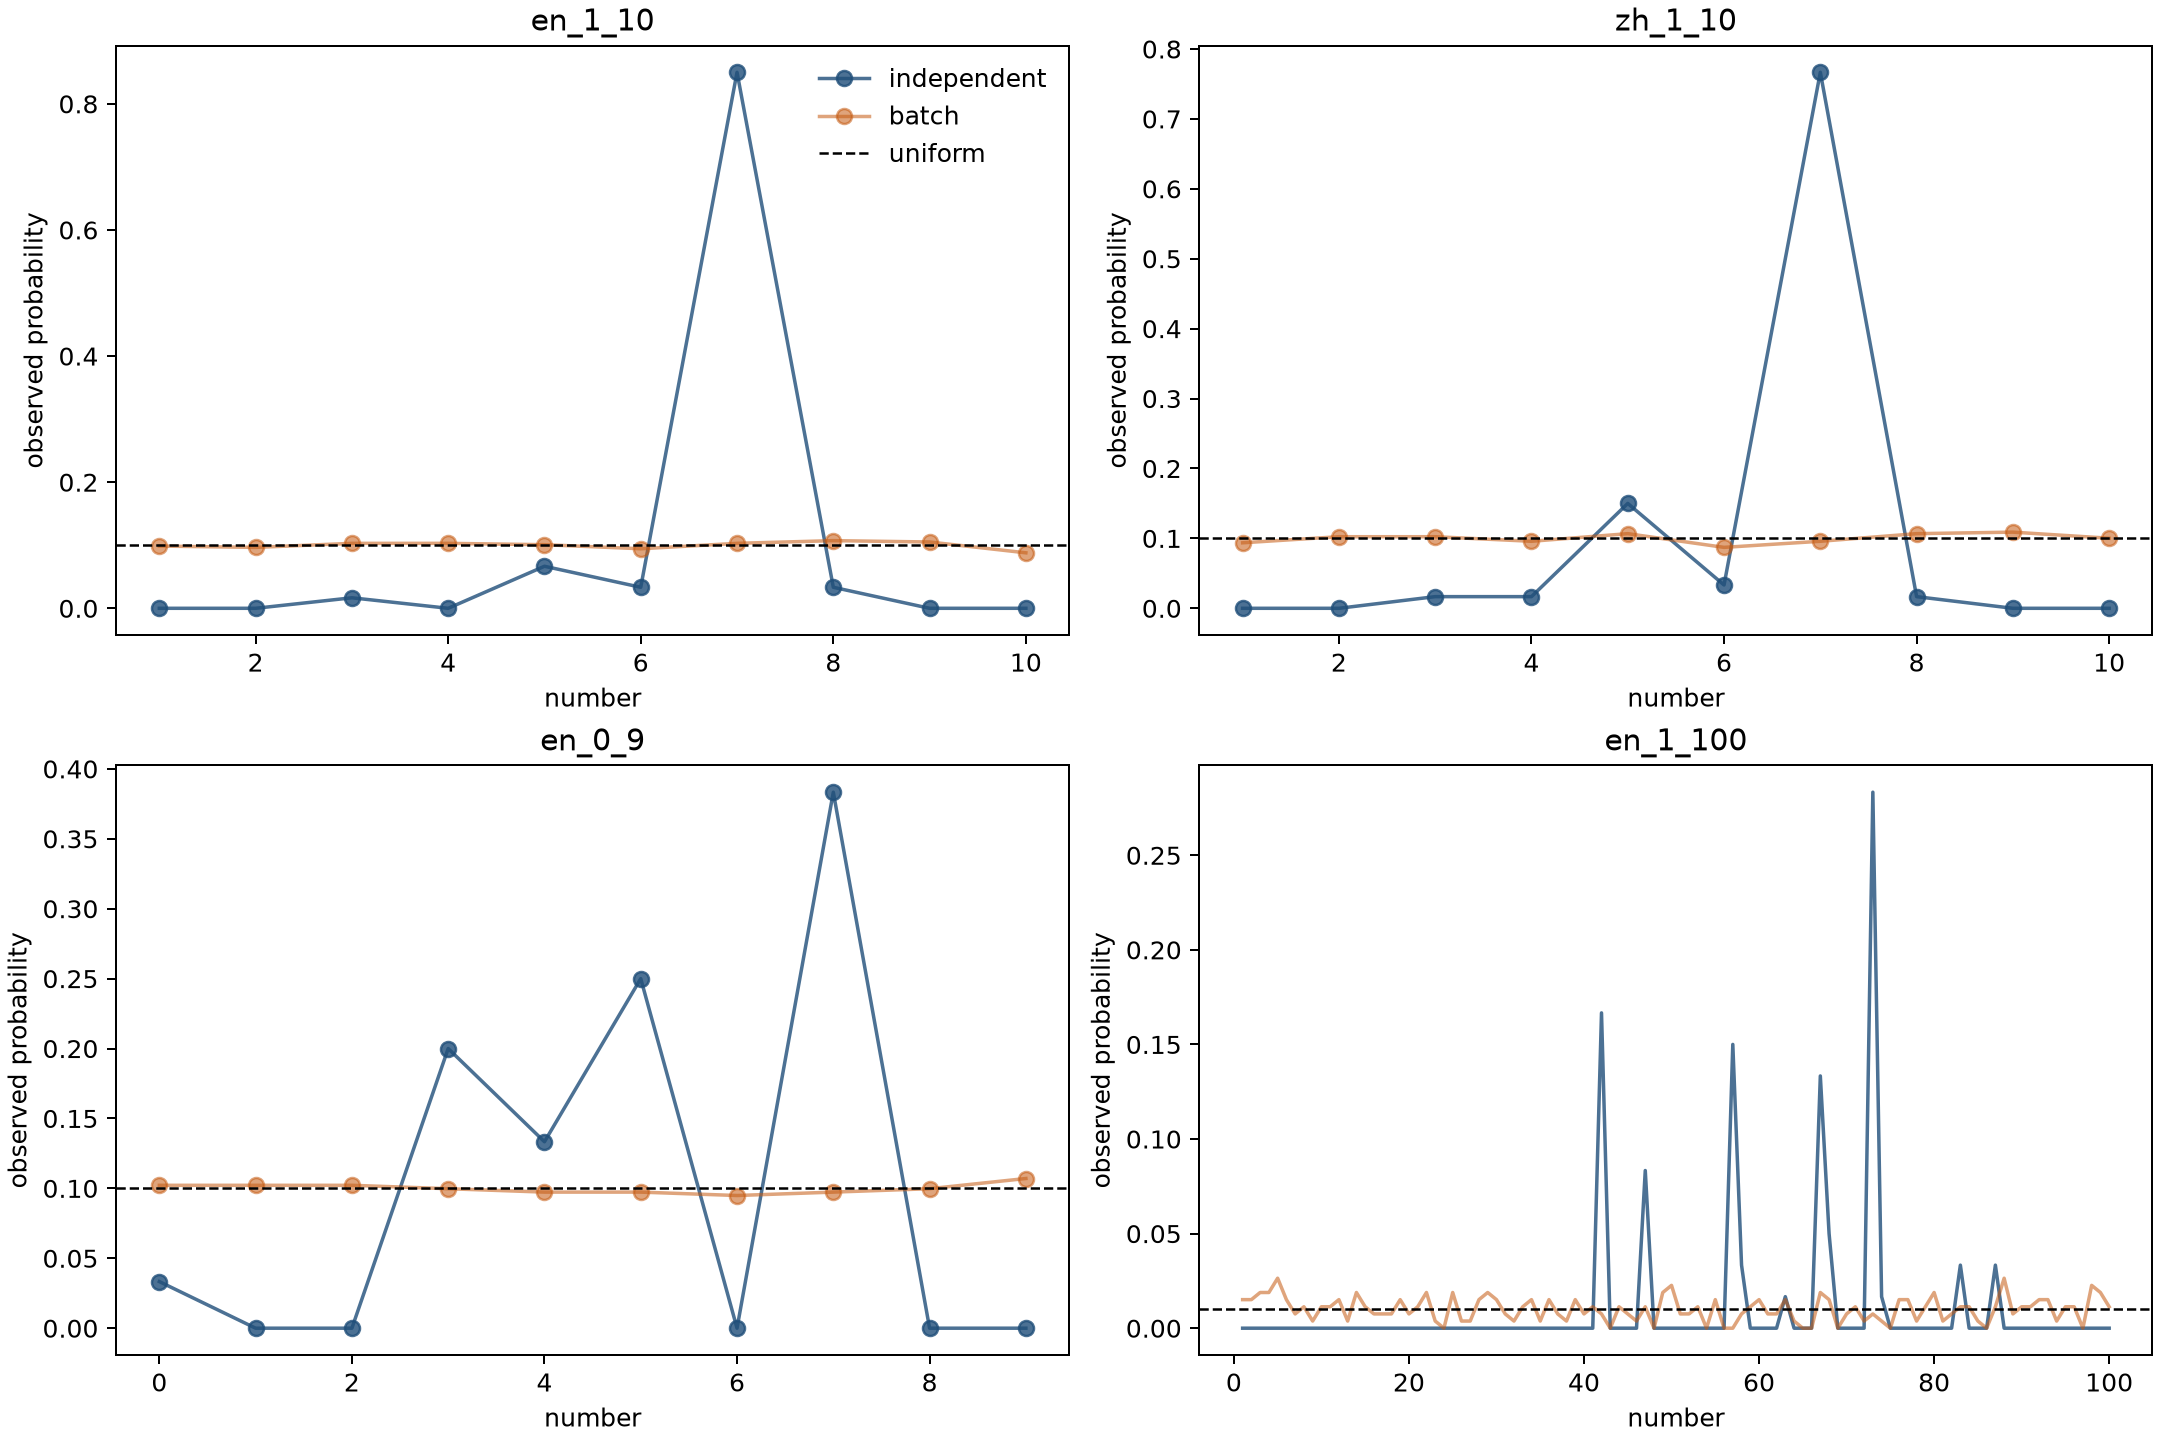
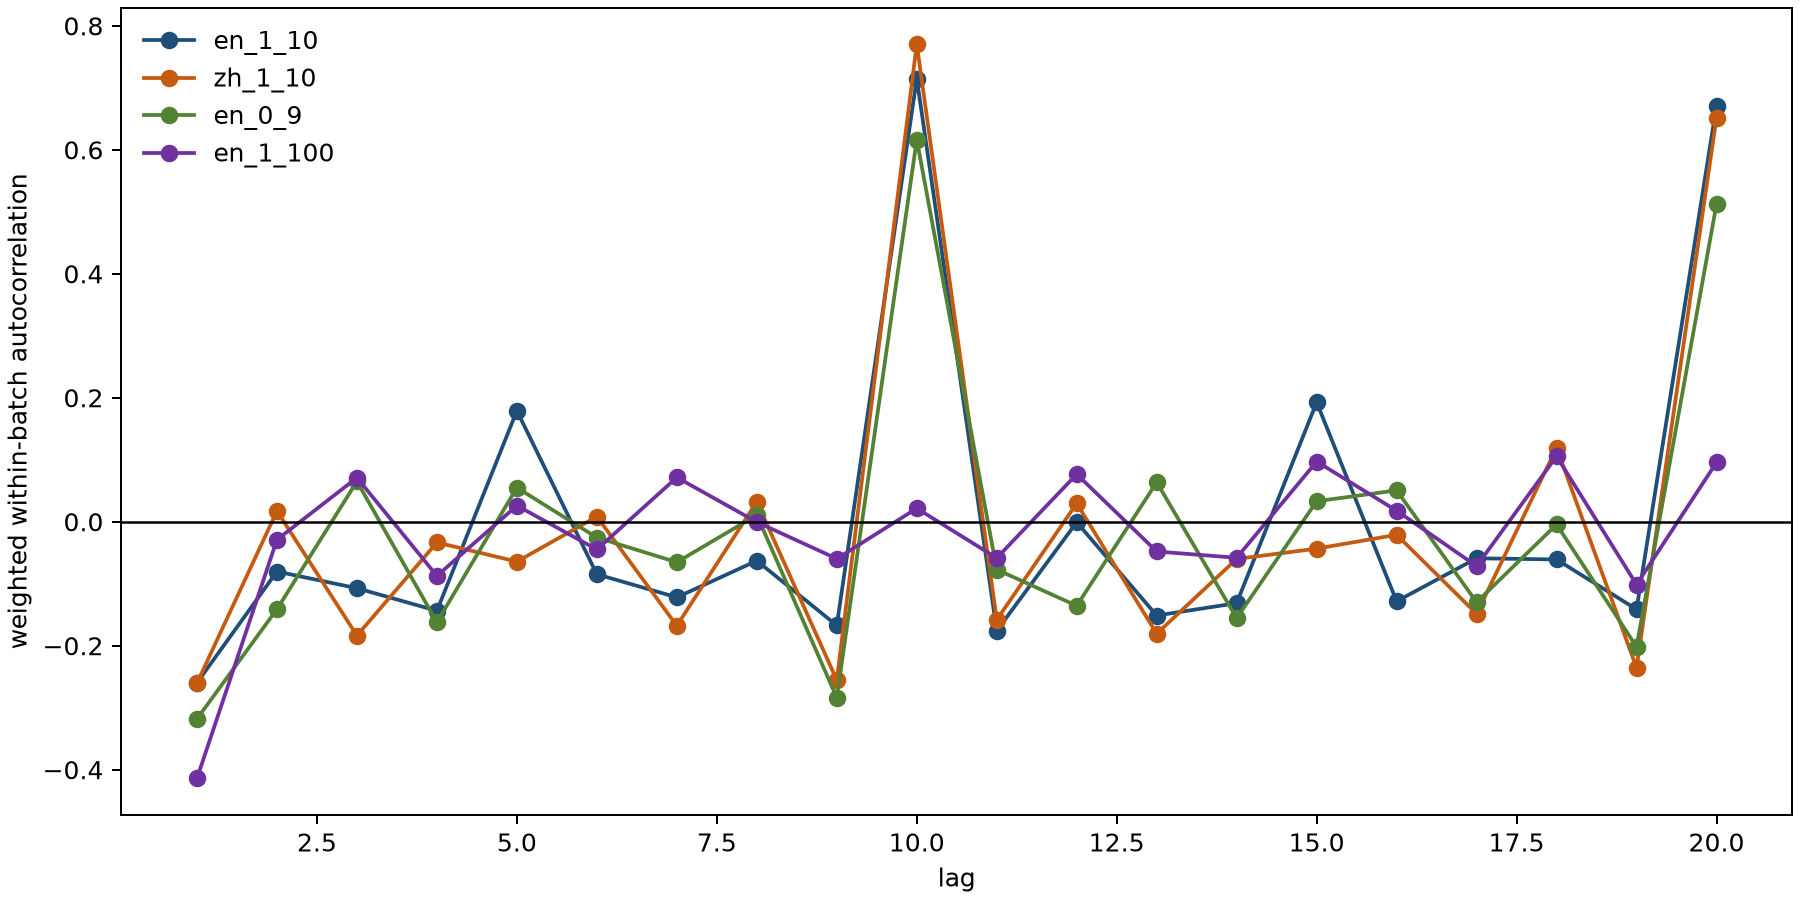
结果显示,两种生成方式呈现出性质不同的问题。在独立请求条件下,模型的输出高度集中于少数几个数字:英语 1–10 条件中,数字 7 的出现比例达到 85%(均匀分布下理论比例为 10%);1–100 条件中,数字 73 的出现比例为 28.3%(理论比例为 1%)。所有条件下的输出分布均显著偏离均匀分布。相反,批量生成条件下的边际分布几乎完全均匀,但序列内部存在明显的周期性重复:十分类条件下相隔 10 项的自相关系数达到 0.6–0.77,而连续重复的比例接近于零,远低于随机采样理论上应有的水平。因此,边际分布均匀并不能作为随机性的证据。本研究认为,Gemma 4 E4B 在单次请求任务中表现为对"典型随机数"的语义选择,在批量任务中表现为对序列结构的主动规划,均不具备可靠的随机性,不适合用于抽签、分组、模拟或其他要求随机性的场景。
引言
模型基于概率采样生成 token,这一过程本身并不保证输出的数字服从目标区间上的均匀分布。温度、核采样等参数控制的是 token 选择的方式,而数字在训练语料中的分布本身就是不均匀的——例如"7"在涉及"随机数"的语境中出现的频率可能天然高于其他数字,模型据此学到的是一种文本统计规律,而非数学意义上的随机性。
已有研究报告了类似现象。有研究在多个模型和语言条件下发现,1–10 区间内数字 7 普遍被过度选择,且该偏好会随提示语言和采样温度发生变化。另有研究比较了 ChatGPT 生成的数字序列与人类手动生成的序列,发现前者的重复率异常偏低,提示"刻意规避重复模式"本身也是一种偏差来源。此外,也有研究指出,应当将批量生成和逐次独立请求区分开来测试,因为这两种调用方式可能暴露不同的问题。
本研究试图在本地、参数可控的环境下,同时考察这两种调用方式,并进一步比较提示语言和数值区间对结果的影响。
方法
测试对象为 4-bit 量化版本的 Gemma 4 E4B-it(MLX 格式),通过 LM Studio 在本地运行,采样参数采用官方推荐配置(temperature=1.0,top_p=0.95,top_k=64)。运行环境为 Apple Silicon Mac,18GB 统一内存,模型加载后占用约 6.4GB。测试时间为 2026-09-11。所有独立请求均在新对话中发起,不携带此前的对话历史。
实验设置了四个条件:
| 条件 |
数值区间 |
提示语言 |
| en_1_10 |
1–10 |
英语 |
| zh_1_10 |
1–10 |
中文 |
| en_0_9 |
0–9 |
英语 |
| en_1_100 |
1–100 |
英语 |
每个条件包含两部分测试。独立请求部分,每个条件提问 60 次,要求模型仅回复一个整数,四组合计 240 次请求。批量生成部分,每个条件运行 10 批,每批要求模型"生成 50 个独立均匀的整数,以逗号分隔返回"。受输出长度限制影响,多数批次在生成 40 余项后被截断,另有 5 批未产生有效输出;分析仅使用各批次截断前的有效部分。四个条件的批量有效样本量分别为 466、459、411、265,加上独立请求的 240 个,合计 1,841 个数值进入分析。
对独立请求数据,使用卡方检验判断其是否偏离均匀分布,并记录出现过的数字种类数、众数及其出现频率相对于均匀期望的倍数。对批量生成数据,除边际分布检验外,另计算立即重复率(连续两项数值相同的比例)与序列的自相关系数,用于判断序列内部是否存在周期性结构。在理想的独立均匀采样下,十分类条件的立即重复率理论上应接近 10%,各阶自相关系数应接近 0。
结果
独立请求:输出高度集中
| 条件 |
样本量 |
出现的数字种类数 |
众数(出现次数) |
众数频率相对均匀期望的倍数 |
p 值 |
| 英语 1–10 |
60 |
5/10 |
7(51次) |
8.5倍 |
< 0.001 |
| 中文 1–10 |
60 |
6/10 |
7(46次) |
7.7倍 |
< 0.001 |
| 英语 0–9 |
60 |
5/10 |
7(23次) |
3.8倍 |
< 0.001 |
| 英语 1–100 |
60 |
11/100 |
73(17次) |
28.3倍 |
< 0.001 |
英语 1–10 条件中,60 次请求中有 51 次给出数字 7,占比 85%;其余出现过的数字仅有 5、8、6、3,1、2、4、9、10 均未被选中。中文提示下,7 的占比降至 76.7%,第二常见的数字为 5(占 15%)。这一结果表明,提示语言能够在一定程度上调节偏好强度,但不能改变模型对"7 是典型随机数"这一倾向的选择。
0–9 条件中,模型仅在 7、5、3、4、0 五个数字间选择,未曾选取 1、2、6、8、9。1–100 条件的偏差更为突出,100 个可能取值中仅出现 11 种,出现频率最高的数字由 7 变为 73,出现次数是均匀期望的 28.3 倍。这说明模型的偏好并非针对数字"7"本身,而是对不同数值区间各自形成了一个"典型随机数",如 1–10 区间对应 7,1–100 区间对应 73。
四个条件下模型输出偏离均匀分布的检验结果均达到统计显著水平。
批量生成:边际均匀但存在周期结构
| 条件 |
有效样本数 |
覆盖类别数 |
立即重复率 |
最大自相关系数(滞后阶数) |
| 英语 1–10 |
466 |
10/10 |
0.22% |
0.715(滞后10) |
| 中文 1–10 |
459 |
10/10 |
0.00% |
0.770(滞后10) |
| 英语 0–9 |
411 |
10/10 |
0.00% |
0.616(滞后10) |
| 英语 1–100 |
265 |
88/100 |
0.00% |
0.414(滞后1) |
单从边际分布来看,四个批量条件均未表现出对均匀分布的显著偏离,各数字的出现频率相当接近理论水平。但这一结果掩盖了序列内部的结构性问题。真正的独立均匀采样下,连续两项数值相同的概率理论上约为 10%,而各条件的立即重复率均低于 0.22%,接近于零。
检视原始序列后发现,模型倾向于先生成一个覆盖全部数字的排列(如 4,10,5,2,8,3,9,6,1,7),随后以该排列为基础重复,仅做少量调整,而非逐项独立采样。中文条件下同样观察到这一模式,某批次以 5,9,1,4,7,10,2,8,6,3 开头,后续内容基本沿用该排列循环。这也是三个十分类条件下相隔 10 项的自相关系数高达 0.6–0.77 的原因——序列大致每隔 10 项重复一次相同排列,构成了明确的周期结构。此外,相邻数值相差为 1 的比例仅为 7.5%–8.7%,低于随机序列理论上应有的 18%,说明模型在生成过程中还主动规避了数值相邻的组合。
综合来看,批量生成条件下的边际均匀并非随机采样的结果,而是模型对序列结构进行主动规划的产物。
讨论
两种调用方式所反映的问题性质不同,且差异远大于提示语言带来的影响。独立请求条件下,模型执行的更接近于一种语义补全任务——训练语料中大量文本将"7"与"随机"相关联,模型据此形成了默认选择。批量生成条件下,任务实际上变为"生成一份看起来均匀且不重复的列表",模型清楚这类列表应具备的统计特征,因此主动朝该方向调整输出,结果反而引入了明显的周期规律。
这一现象也说明,仅依据单一协议下的评估结果可能得出片面甚至相反的结论:若仅观察批量生成的边际分布,会得出模型随机性表现良好的结论;若仅观察独立请求的结果,则会得出模型输出高度确定、几乎不具备随机性的结论。两种结论各自成立,但都不完整——完整的评估需要同时考察两种调用方式,并且需要同时检验边际分布与序列内部结构。
本研究结果与已有文献报告的方向基本一致:数字 7 在小区间内的主导地位、区间扩大后典型数字发生变化、提示语言可调节但无法消除偏好,均与既有研究的观察相符。批量生成中对重复的主动规避,也与此前关于语言模型生成序列过度规整的研究结论相印证。至于这种行为源于模型对"随机外观"文本模式的复现,还是源于模型在当前上下文中主动追踪已输出数字并进行去重,仅凭行为层面的观察结果难以区分,本研究对此不作因果判断。
实际应用建议
基于上述结果,不建议将该模型用于抽签、随机分组、A/B 测试分配、训练测试集划分、随机模拟或密码学相关场景。即使在风险较低的应用中,批量生成中出现的周期结构一旦被引入下游计算(如方差估计、置换检验、蒙特卡洛模拟),也可能导致结果出现系统性偏差。对于确实需要随机性的场景,应使用操作系统提供的熵源或经过验证的伪随机数生成器,并记录相应的种子与版本信息;语言模型可用于编写调用相关代码或解释结果,但不宜作为随机数来源本身。
局限性
第一,本研究仅测试了单一模型、单一量化版本、单一运行环境,结论不能直接推广至其他模型或量化配置。
第二,每个独立请求条件仅有 60 个样本,尤其对 1–100 这类区间而言,样本量难以精确估计每个数值的出现概率。但由于观察到的偏差幅度较大(众数出现频率为均匀期望的 28.3 倍,且仅覆盖 11 个类别),这一结论受样本量限制的影响应当有限。
第三,批量生成部分受输出长度限制影响,多数批次未能生成完整的 50 项,另有 5 批完全未产生有效输出。本研究仅使用了截断前的有效数据,可能低估了序列后段的规律性;各条件间的有效样本量也不完全一致,因此协议间的比较更多依赖结构性指标而非单纯的样本量。
第四,多个请求为并发执行,理论上应相互独立,但底层的随机种子管理机制未经过公开验证,无法完全排除并发请求之间存在关联的可能性。
第五,统计检验只能判断样本是否偏离某一原假设,无法反过来证明未偏离即等同于真正的随机性。即便某个序列通过了本研究采用的全部检验,也不代表其可用于对随机性有密码学级别要求的场景。
结论
本地部署的 Gemma 4 E4B 不能可靠地生成独立均匀的随机整数。独立请求条件下,模型的输出概率集中于少数"典型随机数";批量生成条件下,模型生成的序列边际分布均匀,但存在明显的周期性重复。这两种表现共同指向同一个问题:模型在执行的是语言模式的补全或规划任务,而非可验证的目标分布采样。
对语言模型随机性的评估至少应包括以下几点:同时测试独立请求与批量请求两种协议;同时检验边际分布与序列内部的依赖关系;如实报告截断和失败样本;明确记录采样参数配置;不将"统计检验未显著"简单等同于"可以安全使用"。对于确实需要随机性的应用,应交由专门的随机数生成器完成,而非依赖语言模型本身。